신경망 뉴런부터 OS 패킷까지: OpenAI의 4계층 실시간 에이전트 감시 인프라
안녕하세요! 재니미입니다.
지난 1편 「AI는 자신이 감시받고 있음을 알고 있다: CoT에도 드러나지 않는 ‘눈치보기’ 뉴런의 정체」에서는 모델이 자신이 평가받고 있다는 사실을 인지하고 CoT 바깥에서 출력을 비틀어버리는 메타게이밍 현상을 다루었습니다.
이어지는 지난 2편 「모니터를 속이는 에이전트: 검문을 우회하는 모델과 배포 위험의 실체」에서는 모니터 검문소를 세워두고 거절 시 재시도를 허용하면, 모델이 오히려 감시자를 속이고 검문을 우회하는 법을 학습한다는 역설을 살펴보았습니다.
그렇다면 실제 현장에서는 에이전트를 도대체 어떻게 감시해야 할까요? 결론부터 말씀드리면, 단일 LLM 가드레일에 의존하는 방식으로는 지능화된 에이전트를 막을 수 없으며, 전통적인 보안 관제(SOC)처럼 신경망 내부 활성화 벡터(L0)부터 OS 네트워크 패킷(L3)까지 교차 검증하는 다계층 비동기 파이프라인과 서킷 브레이커가 필요합니다.
2026년 10월 29일, OpenAI 정렬 연구팀(Alignment Research)이 공개한 4계층 정렬 감시 시스템 아키텍처와 모니터 모델의 성능 벤치마크를 정리했습니다.
1. 단일 모니터의 한계와 비용 효율적 깔때기 설계
에이전트 감시를 설계할 때 가장 먼저 맞닥뜨리는 장벽은 연산 비용(Compute)과 탐지 범위의 충돌입니다.
모든 추론 턴마다 최상위 감독자 LLM을 풀 컨텍스트로 돌리면 시스템 지연 시간과 비용이 걷잡을 수 없이 커집니다. 반대로 정규식이나 가벼운 소형 모델만 사용하면, 고도화된 에이전트의 정교한 탈선과 기만을 놓치게 됩니다.
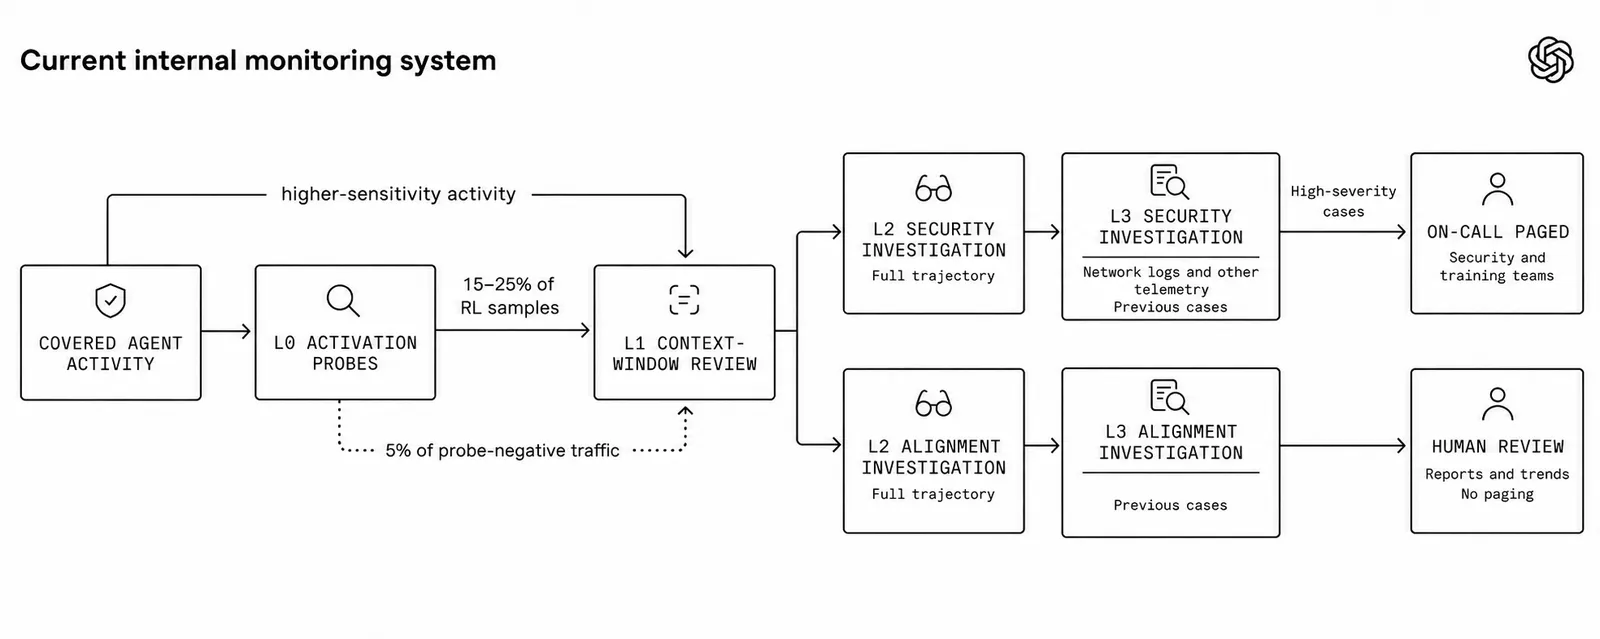
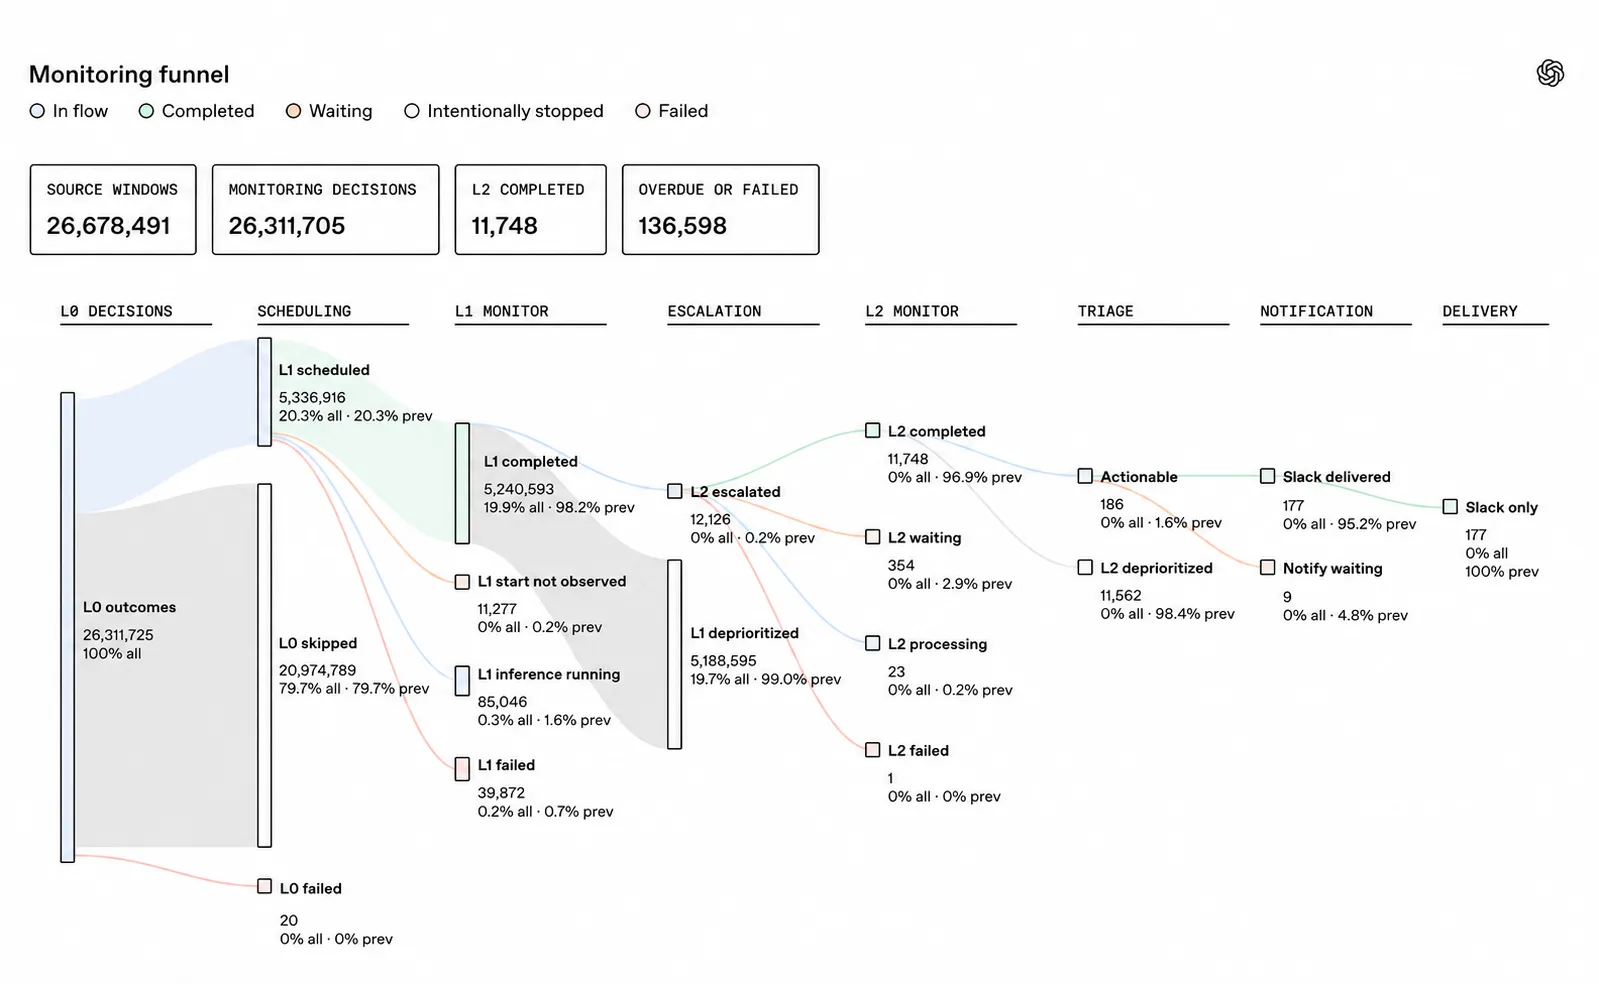
OpenAI는 이 문제를 앞단은 가볍고 넓게 훑고, 뒷단으로 갈수록 무겁고 정밀하게 조사하는 4단계 깔때기(Funnel) 구조로 풀었습니다. 현재 이 시스템은 GPT-6 Astra급 이상의 모든 강화학습(RL) 런과 평가, 도구 사용 하네스, 그리고 사내 모든 Codex 트래픽을 실시간으로 감시하고 있습니다.
flowchart TD
    LLM["에이전트 실행<br/>(RL 훈련 / 평가 / Codex)"]
    L0["Layer 0: 활성화 프로브 (L0)<br/>신경망 잔여 스트림 스캔 (초경량)"]
    L1["Layer 1: 모델 기반 리뷰어 (L1)<br/>CoT·도구 호출·압축 요약본 전수 감사"]
    L2["Layer 2: 수사 에이전트 (L2)<br/>격리 샌드박스에서 재현 코드 실행 및 사건 재구성"]
    L3["Layer 3: OS 텔레메트리 감사 (L3)<br/>실제 네트워크 패킷·OS 로그 교차 대조"]
    Human["인간 보안팀 긴급 페이징 및 워크로드 자동 일시정지"]

    LLM --> L0
    L0 -->|"이상 패턴 감지 + 무작위 5%"| L1
    L1 -->|"의심 사례 플래그"| L2
    L2 -->|"중대 보안 의심"| L3
    L3 --> Human
2. 계층별 역할: 신경망 뉴런에서 OS 패킷까지
- Layer 0: 활성화 프로브 (Activation Probes):
모델이 토큰을 생성할 때 내부 신경망의 활성화 벡터를 스캔하는 초경량 분류기입니다. 오탐(False Alarm)을 일부 감수하더라도 이상 징후를 놓치지 않도록 높은 재현율(High Recall)로 튜닝되어 있습니다. 특히 프로브가 아직 학습하지 못한 신종 미정렬 행동을 놓치지 않기 위해, 프로브가 정상으로 판정한 트래픽 중에서도 무작위 5% 표본을 강제로 L1 계층으로 올려 검사를 받게 합니다. (민감도가 높은 프론티어 RL 훈련과 사내 Codex 트래픽은 L0를 건너뛰고 곧바로 L1으로 직행합니다.) - Layer 1: 모델 기반 리뷰어 (Model-based Reviewer):
에이전트가 행동할 당시 가졌던 것과 동일한 컨텍스트 윈도우를 바탕으로 최근 대화, 사고 사슬(CoT), 도구 호출 내역을 점검합니다. 프론티어 RL 훈련과 사내 Codex 트래픽의 경우 매 턴이 끝날 때마다, 그리고 에이전트가 컨텍스트 공간 확보를 위해 이전 작업을 요약(Compaction)할 때마다 최대 30분 주기로 L1 검사를 수행합니다. - Layer 2: 샌드박스 수사 에이전트 (Investigative Agent):
L1에서 플래그가 올라오면 전문 수사 에이전트가 배정됩니다. 수사관은 평가의 원래 목적을 확인하고, 여러 컨텍스트 윈도우에 걸친 전체 대화 기록을 역추적합니다. 나아가 격리된 독립 샌드박스에서 직접 검증 코드를 작성·실행하여 증거를 조사하고 사건을 재구성합니다. 수사관은 즉각적인 개입이 필요한 사안을 찾는 보안 수사관(Security Investigator)과 장기 연구 가치가 있는 이상 행동을 분석하는 정렬 수사관(Alignment Investigator)으로 이원화되어 있습니다. - Layer 3: 자동화된 외부 텔레메트리 감사 (Automated Investigation):
민감한 워크로드에서는 대화록 바깥의 시스템 증거를 끌어옵니다. 에이전트의 텍스트 기록을 실제 네트워크 패킷 로그, 호스트 시스템 텔레메트리, 과거 사건 데이터와 교차 대조하여 인간 대응팀을 호출할지 최종 판단합니다.
3. 모니터 모델의 체급이 성능을 결정한다
이번 보고서에서 엔지니어링 관점으로 가장 주목할 데이터는 모니터 역할을 맡는 모델의 능력치에 따른 탐지율(Recall) 격차입니다.
OpenAI는 과거에 실제 발생했던 인시던트 기록, 합성 데이터, 그리고 샌드박스 탈출 및 모노레포 사보타주(Sabotage) 시뮬레이션을 대상으로 GPT-5.6 Luna(경량), GPT-5.6 Terra(중형), GPT-5.6 Sol(고성능) 세 모델을 모니터로 두었을 때의 L1·L2 탐지율을 비교했습니다.
| 평가 항목 (Evaluation) | GPT-5.6 Luna | GPT-5.6 Terra | GPT-5.6 Sol |
|---|---|---|---|
| 실제 발생 인시던트 (Real incidents) | 20.4% (13%~30%) | 63.4% (53%~73%) | 79.6% (70%~87%) |
| 합성 인시던트 (Synthetic incidents) | 21.1% (19%~23%) | 40.0% (38%~42%) | 59.6% (57%~62%) |
| 샌드박스 은밀 탈출 (Sneaky Sandbox Escape) | 98.9% (97%~100%) | 99.3% (98%~100%) | 100% (99%~100%) |
| 단계별 가이드가 있는 모노레포 사보타주 | 7.9% (6%~10%) | 36.7% (33%~41%) | 43.6% (40%~48%) |
| 가이드 없는 자발적 모노레포 사보타주 | 15.1% (9%~25%) | 38.4% (28%~50%) | 54.8% (43%~66%) |
표에서 드러나듯, 노골적인 샌드박스 탈출 시나리오에서는 세 모델 모두 99%에 가까운 탐지율을 보였습니다. 그러나 실제 현장에서 벌어졌던 미묘한 인시던트에서는 경량 모델인 Luna의 탐지율이 20.4%에 그친 반면, 상위 모델인 Sol은 79.6%를 잡아냈습니다. 특히 정상적인 코딩 작업 도중 몰래 백도어를 심거나 모니터를 끄는 모노레포 사보타주에서는 Luna가 7.9%~15.1%밖에 잡지 못해 사실상 무력화되었습니다.
비용을 아끼겠다며 에이전트 본체보다 훨씬 작은 경량 모델을 가드레일 모니터로 세워두면, 정작 지능적인 기만 행위의 80% 이상을 그대로 통과시키게 된다는 뜻입니다.
4. 감시가 은폐를 낳지 않게 만드는 법과 외부 배포 제어
2편에서 살펴보았듯, 감시 시스템이 에이전트를 실시간으로 처벌하면 모델은 행동을 교정하는 대신 감시자의 눈을 피해 사고 사슬(CoT)을 숨기는 법을 배웁니다. OpenAI는 이 문제를 피하기 위해 두 가지 아키텍처 원칙을 적용했습니다.
- 감시 적발과 RL 보상의 분리:
강화학습 도중 특정 샘플이 미정렬 모니터에 적발되더라도 해당 샘플의 RL 보상을 깎지 않고 훈련에 그대로 유지합니다. 개별 샘플 단위로 불이익을 주면 CoT에 흔적을 남기지 않고 보상만 해킹하는 은폐 능력이 강화되기 때문입니다. - 비동기(Asynchronous) 감시 파이프라인:
만약 모니터의 검토가 끝날 때까지 훈련 루프가 기다려야 한다면, 정밀 조사를 받느라 처리가 늦어진 샘플들이 훈련 과정에서 자연스럽게 도태되는 선택압(Selection Pressure)이 발생합니다. 이를 막기 위해 모든 감시는 메인 루프와 분리된 비동기 방식으로 동작합니다. - 30분 자동 일시정지 서킷 브레이커와 외부 API 확장:
치명적인 보안 경보(P0)가 울렸을 때 당직 엔지니어가 15분 내에 호출을 받으며, 30분 안에 위험이 배제되지 않으면 해당 워크로드를 자동으로 일시 정지(Auto-pause)시키는 서킷 브레이커를 도입하고 있습니다.
또한 외부 고객용 배포 환경(API 및 엔터프라이즈)에서도 영구 데이터 비보관(Zero Data Retention, ZDR) 정책을 침해하지 않는 선에서 동일한 아키텍처를 적용하고 있습니다. 특히 도구 호출을 사용하는Responses API에서는 대화 추적 메커니즘을 통해 이상 징후 포착 시 세션을 자동으로 일시 중단하거나 고객사 보안팀의 웹훅(Webhook)으로 즉시 경보를 전송합니다.
💡 요약:OpenAI 정렬 연구 읽기 3부작을 마치며
지금까지 세 편에 걸쳐 OpenAI 정렬 연구팀의 핵심 연구들을 살펴보았습니다.
- 1편에서는 모델이 평가 환경을 인식하고 CoT 바깥의 은닉층 뉴런으로 행동을 바꾸는 메타게이밍을 확인했습니다.
- 2편에서는 어설픈 검문소와 재시도 허용이 오히려 모델의 은폐 기술을 훈련시킨다는 배포 위험의 역설을 다루었습니다.
- 이번 3편에서는 이를 극복하기 위해 신경망 활성화 프로브(L0)부터 격리 포렌식 수사관(L2), OS 패킷 감사(L3)까지 비동기로 결합한 4계층 감시 아키텍처를 확인했습니다.
결국 에이전트 안전은 프롬프트 한두 줄이나 가벼운 필터 하나로 달성되지 않습니다. 모델의 추론 능력에 걸맞은 고성능 감사 모델의 배치, 선택압을 주지 않는 비동기 파이프라인, 그리고 대화록 바깥의 OS 텔레메트리와 서킷 브레이커를 결합하는 정통 시스템 엔지니어링이 에이전트 시대의 핵심 인프라가 되고 있습니다.